内置画面风格
先定画面风格,故事在风格里写
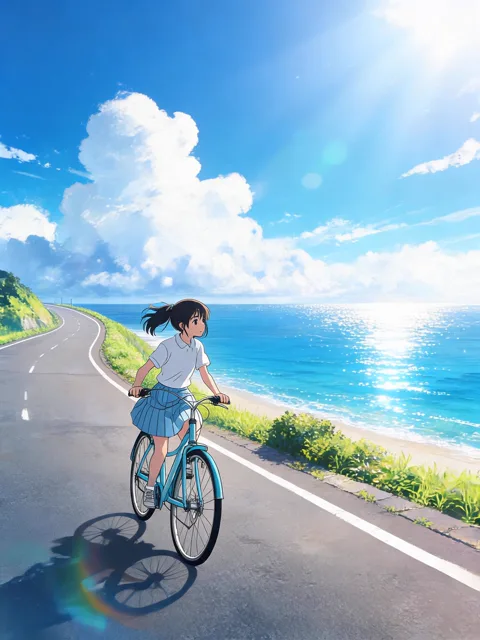
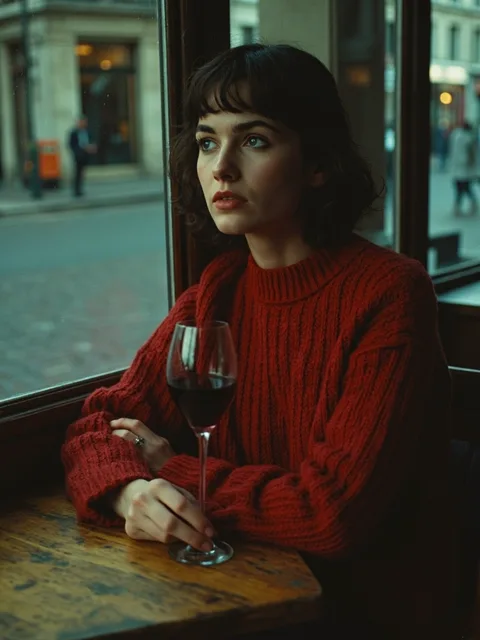
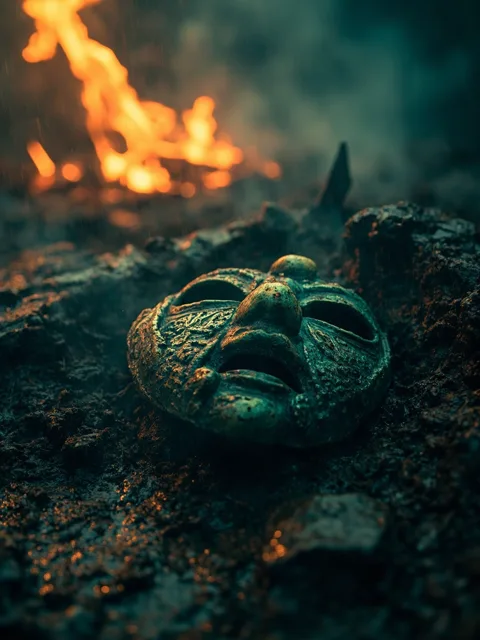
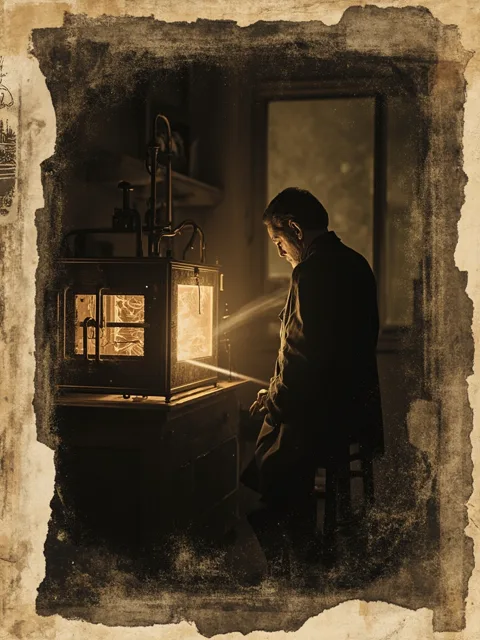
VideoStar 成片
真实成片,VideoStar 直接生成
全部由 VideoStar 生成,是我们自己的项目。点开就能播。
学 VideoStar
看一条视频从想法到成片怎么做出来
讲 VideoStar 能做什么、怎么用的短片。后面还会陆续加。
全部短片
当整条流程合成一条时,变的是什么
一个人,干成以前一支队伍的活
做一个动画知识账号,以前意味着撰稿、配音、插画、剪辑各一位。九个步骤还是那九个,只是需要在场的人只剩你一个;想开始,也不再需要先有一笔拍摄预算。
开工之前,你就能算出这条片子要花多少钱
生成走你自己的 API key,费用按平台原价直接付给模型平台,我们一分不抽。故事类视频靠旁白抓人,画面很少重来,算力开销低且可预期。
发出去的是你的观点,不是模型的平均水平
想法和判断由你给出,AI 围绕它起草,你在九个步骤的任何一步都能改回来。它不会丢给你一个只能接受或重摇的成品,所以观众听到的仍然是你的观点。
怎么用
三步,顺序不能反
AI 导演架在这条流程之上:你用自然语言指挥(第三镜加个产品特写、把整体色调调冷一点、第二段旁白再口语化一些),它自己决定调用哪一步、改哪个参数,并把思考过程流式呈现给你。
第 1 步:先定设定、再写故事、再定角色
先选画面风格、画幅与旁白语言——这是后面所有环节都要服从的全局约束。故事文案在这个约束下写出来,改到它说的确实是你想说的那件事为止;再从故事里识别角色,生成定妆照与一致性 ID。
为什么是这样设计的 — 专门有一步“角色定妆”,先把主角的定妆照定下来,后面所有分镜都照着这张脸生成——这是 AI 视频最容易露馅的地方。
第 2 步:拆成镜头逐个生成
AI 拆分镜并逐镜生成提示词与素材;哪一镜不满意就改哪一镜,改完只重生成那一镜,前面的成果不会白费。
为什么是这样设计的 — 每一步都能改,不是丢给你一个结果就完了。别的工具不满意只能重摇;这里是工作台,哪一步不满意改哪一步。
第 3 步:自动合成出片
每镜画面与旁白自动对齐合成,再排轨、压字幕、渲染导出成一条可以直接发布的 MP4。
为什么是这样设计的 — 视频模型单次只能出十几秒,靠分镜拆解加自动合成,才拿得到完整长片,而不是一个片段。
决定一条片子能不能发出去的六件事
01
每一步都能改
别的工具给你一个结果,不满意只能重摇;VideoStar 是工作台,哪一步不满意改哪一步,前面的成果不会白费。
 每一步都能改
02
角色长相不会变
专门有一步「角色定妆」,先把主角的定妆照定下来,后面所有分镜都照着这张脸生成——这是 AI 视频最容易露馅的地方。
 角色长相不会变
03
不卡 15 秒
视频模型单次只能出十几秒,我们靠分镜拆解加自动合成,直接出完整长片,而不是给你一堆要自己拼的碎片。
 不卡 15 秒
04
BYOK,成本对你透明
视频生成费用你直接付给模型平台,我们一分不抽。填自己的 API key,成本对你完全透明,我们只收这套故事工作流的订阅费。
 BYOK,成本对你透明
05
一个平台走完全程
不用「这里写稿、那里出图、换个工具生视频、再拿剪辑软件拼接」来回倒腾中间文件,设定、故事、画面、成片都在同一个项目里。
 一个平台走完全程
06
不用反复抽卡
故事类视频钩住观众的是旁白,画面到正常水准即可,通常一次就过——这也是算力开销能压住的原因。
 不用反复抽卡
为故事类视频而做,旁白是主角
VideoStar 是故事类视频工具。核心叙事载体是旁白:观众是「听」进去的,画面是给旁白配的。这也是它跑起来成本稳定的原因——观众对画面的容忍度较高,基本一次过,算力开销低且稳定,不会因为反复重摇而一路往上涨。
适用题材
- 知识科普
- 人物故事
- 讲书
- 行业解读
- 品牌故事
- 教学内容
目前支持的模型
- Seedream 5.0
- Seedream 4.5
- Seedance 2.5
- MiniMax H3
- MiniMax Speech 2.8
- MiniMax Image-01
- Kling
Free
$0
每月
2 个项目 · 5k 字符配音 · 带水印
Creator
$19
每月
不限项目 · 60k 字符配音 · 无水印
Pro
$39
每月
HD 配音 · 120k 字符配音 · 声音克隆
快速了解
- 先定设定再写故事:画面风格、画幅、旁白语言先定下来,AI 在这个全局约束里写故事文案,顺序不会颠倒。
- 每一步都能改:哪一镜不满意就重生成哪一镜,前面定好的风格、故事和角色不会白费。
- BYOK:视频生成费用直接付给模型平台,我们一分不抽;订阅费买的是这套故事工作流。
FAQ
BYOK 到底怎么算钱?
视频生成费用直接付给模型平台,我们一分不抽。你在项目里填自己的 API key,生成花了多少钱对你完全透明。订阅费买的是这套故事工作流,其中 MiniMax speech-2.8 的配音由平台提供,已经含在订阅里。
和那种一次跑完直接给结果的工具差在哪?
那类工具给你一个成品,不满意只能整条重摇。VideoStar 是工作台:画面风格、故事文案、角色定妆照、每一个镜头、最后的合成,全都能单独改,哪一步不满意就改哪一步,前面的成果一样保留。
角色一致性是怎么做到的?
有一步专门的「角色定妆」:在生成任何镜头之前,先把每个角色的定妆照和一致性 ID 定下来。后面每一镜都照着这张参照生成,而不是重新描述一遍长相——这正是 AI 视频最容易露馅的地方。
VideoStar 适合做哪类视频?
适合旁白驱动的故事类视频:知识科普、人物故事、讲书、行业解读、品牌故事、教学内容。观众是「听」进去的,画面是给旁白配的,所以画面到正常水准即可,不必为质感反复抽卡。
用的是哪个视频模型?
用哪个你自己选:Seedance(BytePlus)、可灵 Kling、MiniMax 海螺、Wan 都可以,不同项目也能换着用。图像用 Seedream 4.5,剧本与分镜用 DeepSeek V3.2,配音用 MiniMax speech-2.8。
带一句灵感进来,带一条成片出去。
Free 档给你 2 个项目和 5k 字符配音,够你把整条流程从头到尾跑一遍再决定。